Pojďme rovnou na to. V článku Na Googlu jste vidět. Doporučí vás i AI? jsme skončili u toho, že pozice v Googlu a viditelnost v AI nejsou totéž. Slíbili jsme, že si rozebereme, jak modely vybírají firmy, které ve svých odpovědích zmíní.
Kolem optimalizace pro AI se za poslední rok a půl nabalilo množství rad, které nikdo nedokládá. Rozsekejte obsah na malé kousky. Nasypte si na web soubor llms.txt. Přidejte schéma. Něco z toho má oporu v dokumentaci výrobců. Něco popisuje techniku, kterou Google vůbec nepoužívá.
Projdeme si proto cestu jednoho dotazu krok za krokem. Od chvíle, kdy ho člověk odešle, až do okamžiku, kdy se v odpovědi objeví odkaz na váš web.
V kostce
- Když člověk na internetu zadá vyhledávací dotaz, nespustí se jedno hledání, ale hned několik naráz. Google tomu říká query fan-out.
- Pro Přehledy od AI neexistuje zvláštní robot. Obsah jim nosí stejný Googlebot jako běžnému vyhledávání.
- Google-Extended není robot. Je to jen přepínač v souboru robots.txt a na Přehledy od AI nemá vliv.
- Většina AI robotů nespouští skripty. Co se na stránce dokresluje až v prohlížeči, nevidí.
- Robots.txt může být v pořádku a robot se přesto dovnitř nedostane. U 6 z 30 českých e-shopů měřených v srpnu 2026 vracel server status 403, tedy přístup odmítnut.
- Do citovaného úryvku se u modelu Claude vejde nejvýš 150 znaků.
- Sekat obsah na malé kousky Google jako podmínku výslovně odmítá. Tahle technika patří do jiných systémů, ne do Googlu.
- Soubor llms.txt Google Search ignoruje. Chrome ho přitom v jednom experimentu kontroluje.
- Kolikrát se váš web ukázal v AI odpovědích Googlu, měří od 31. srpna 2026 report v Search Console. Prokliky v něm nejsou.
Dotaz se nejdřív rozvětví
Když se AI na něco zeptáte, často neudělá jen jedno vyhledávání. Váš dotaz si nejdřív rozloží na několik souvisejících otázek a ty pak hledá souběžně.
Google této technice říká query fan-out, tedy rozvětvení dotazu. Smyslem je získat víc různých podkladů, než by přineslo jedno jediné hledání.
Google uvádí jednoduchý příklad. Když se zeptáte, jak zbavit trávník plevele, systém si může vedle původního dotazu sám vytvořit třeba i dotaz na nejlepší herbicidy. Vy jste se na ně přímo neptali, ale AI si tuto otázku doplnila sama, protože jí pomůže sestavit lepší odpověď (Google Search Central, 2026).
Podobně Google popisuje i Režim AI: otázku rozdělí na menší témata a současně spustí více souvisejících hledání (blog Google, 2025).
Kolik hledání může vzniknout? Google konkrétní číslo neuvádí. Anthropic ale ve své dokumentaci píše, že u jednoduchých faktických dotazů jde typicky až o 3 hledání, zatímco u složitějších srovnání nebo výzkumu více firem jich může být 10 a více (Anthropic, 2026).
Co z toho plyne pro váš web? Nesoutěžíte jen o jedno místo pro jeden přesný dotaz. Vaše stránka se může dostat do odpovědi i přes některý z vedlejších dotazů, které si AI vytvoří sama.
Pravděpodobně je to jeden z důvodů, proč se zdroje v Přehledech od AI často neshodují s běžnou první desítkou Googlu. Podle analýzy Ahrefs bylo jen 37,9 % citovaných zdrojů zároveň v prvních deseti organických výsledcích (Ahrefs, 2025).
Google zároveň říká, že jeho generativní vyhledávání má záměrně nabízet širší a pestřejší výběr užitečných zdrojů než klasické hledání (Google Search Central, 2025).
Neznamená to ale, že samotné rozvětvení dotazu vysvětluje celé číslo 37,9 %. Google takovou souvislost přímo nepotvrzuje. Je to spíš jedno z pravděpodobných vysvětlení.
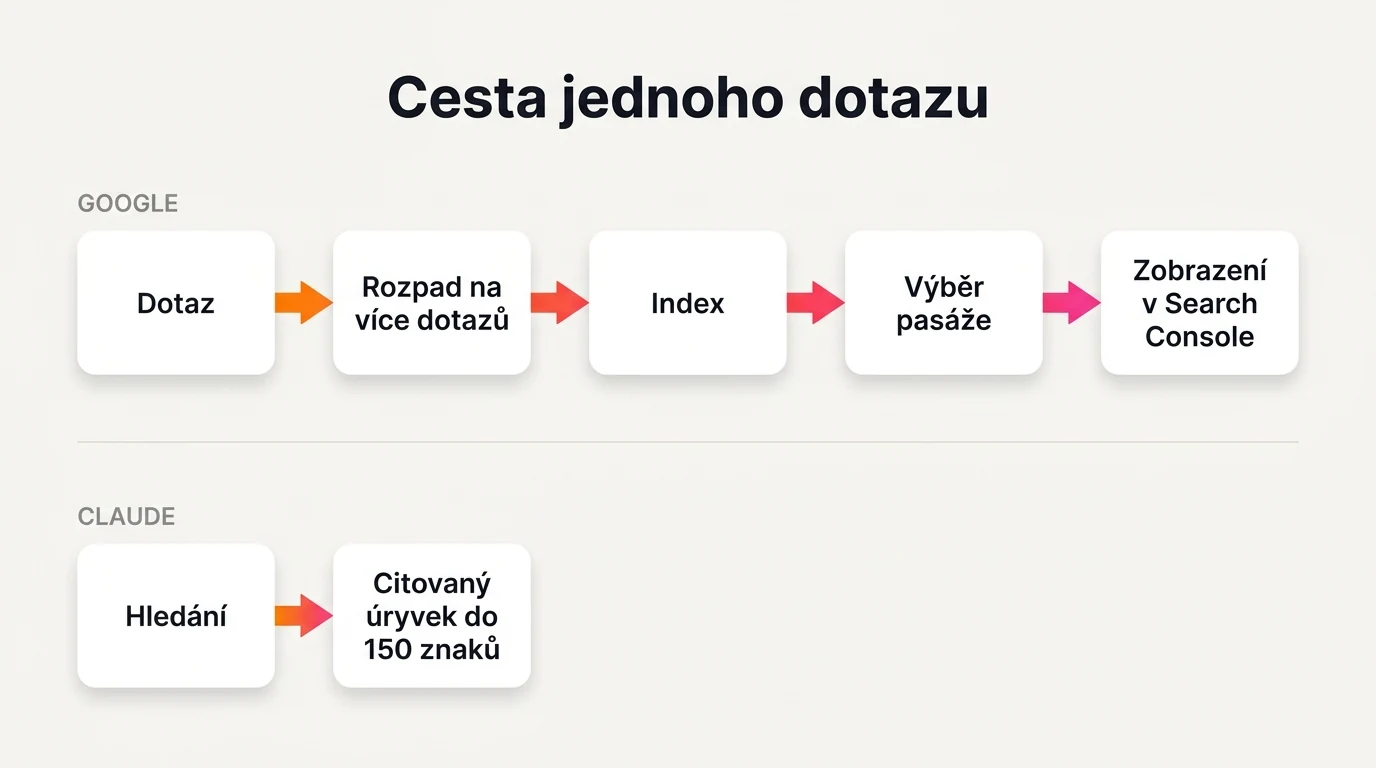
Dvě různé cesty, ne jedna univerzální. Nahoře doložená mechanika Googlu, dole citace podle dokumentace Anthropicu.
Kdo si vlastně vaši stránku stahuje
Když se mluví o AI robotech, často se všechny házejí do jednoho pytle. Jenže ve skutečnosti mohou mít úplně jiný účel. A právě od něj se odvíjí, co se s obsahem vašeho webu dál děje.
Robot je program, který automaticky navštěvuje webové stránky a načítá jejich obsah. U AI služeb se nejčastěji setkáte se 3 typy:
- Roboti pro trénování modelů. GPTBot nebo ClaudeBot mohou obsah webu využít při dalším vývoji a trénování AI modelů. Pokud je zablokujete, dáváte tím najevo, že si nepřejete, aby byl váš obsah k tomuto účelu používán.
- Roboti pro vyhledávání a tvorbu odpovědí. OAI-SearchBot, Claude-SearchBot nebo PerplexityBot procházejí web proto, aby jejich služby měly aktuální podklady pro vyhledávání a odpovědi. Nejde o trénování modelu, ale o získávání informací, které mohou být použity při odpovědi uživateli.
- Načtení stránky na žádost konkrétního člověka. ChatGPT-User, Claude-User nebo Perplexity-User přicházejí na web ve chvíli, kdy si jeho obsah vyžádá uživatel přímo v dané službě.
Zdroje: OpenAI, Anthropic a Perplexity, září 2026.
Co si z toho vzít? Když zablokujete jeden typ robota, neznamená to automaticky zákaz pro všechny ostatní. Můžete například zakázat GPTBot a tím omezit použití svého obsahu pro trénování modelů, ale váš web se stále může objevovat ve výsledcích a odpovědích ChatGPT. Pokud naopak zablokujete OAI-SearchBot, OpenAI uvádí, že se váš web ve výsledcích vyhledávání ChatGPT zobrazovat nebude.
A tady vzniká několik častých nedorozumění.
Google-Extended není samostatný robot. Je to pravidlo v souboru robots.txt, kterým můžete určit, zda Google smí váš obsah využívat pro některé své AI systémy, například Gemini a Vertex AI. Nemá ale vliv na to, jestli se váš web objeví v běžném vyhledávání Google, a Google ho nepoužívá ani jako hodnoticí signál (Google Search Central, 2026).
Z toho plyne i další důležitá věc: zablokováním Google-Extended se z Přehledů od AI ani z Režimu AI neodstraníte.
Pro Přehledy od AI ani Režim AI totiž neexistuje zvláštní robot. Google pro ně používá stejný Googlebot a stejný vyhledávací index jako pro běžné výsledky. Neexistuje tedy jednoduchý přepínač, kterým byste zakázali jen AI odpovědi a přitom zůstali beze změny v klasickém vyhledávání.
Pokud chcete omezit, co se z vašeho webu může v těchto odpovědích zobrazovat, Google doporučuje běžné nástroje, jako jsou nosnippet, data-nosnippet, max-snippet nebo noindex. Jimi určíte, zda se smí zobrazovat úryvek stránky, jak může být dlouhý, případně zda má stránka vůbec zůstat ve vyhledávacím indexu.
Jinak jsou technické podmínky překvapivě jednoduché: stránka musí být zaindexovaná a Google z ní musí smět zobrazit úryvek. Žádné další speciální technické požadavky pro Přehledy od AI Google neuvádí (Google Search Central, 2025).
A nakonec jedna výjimka, která dobře ukazuje, proč samotný robots.txt není skutečná ochrana obsahu.
Perplexity-User může pravidla robots.txt ignorovat. Důvod je jednoduchý: na stránku nepřichází z vlastní iniciativy, ale proto, že si její načtení vyžádal konkrétní uživatel. Perplexity to ve své dokumentaci výslovně uvádí.
Robots.txt je proto lepší chápat jako soubor pravidel pro slušně se chovající roboty, ne jako technickou zábranu. Pokud chcete přístupu opravdu zabránit, musí ho zastavit server, firewall nebo jiná ochrana webu.
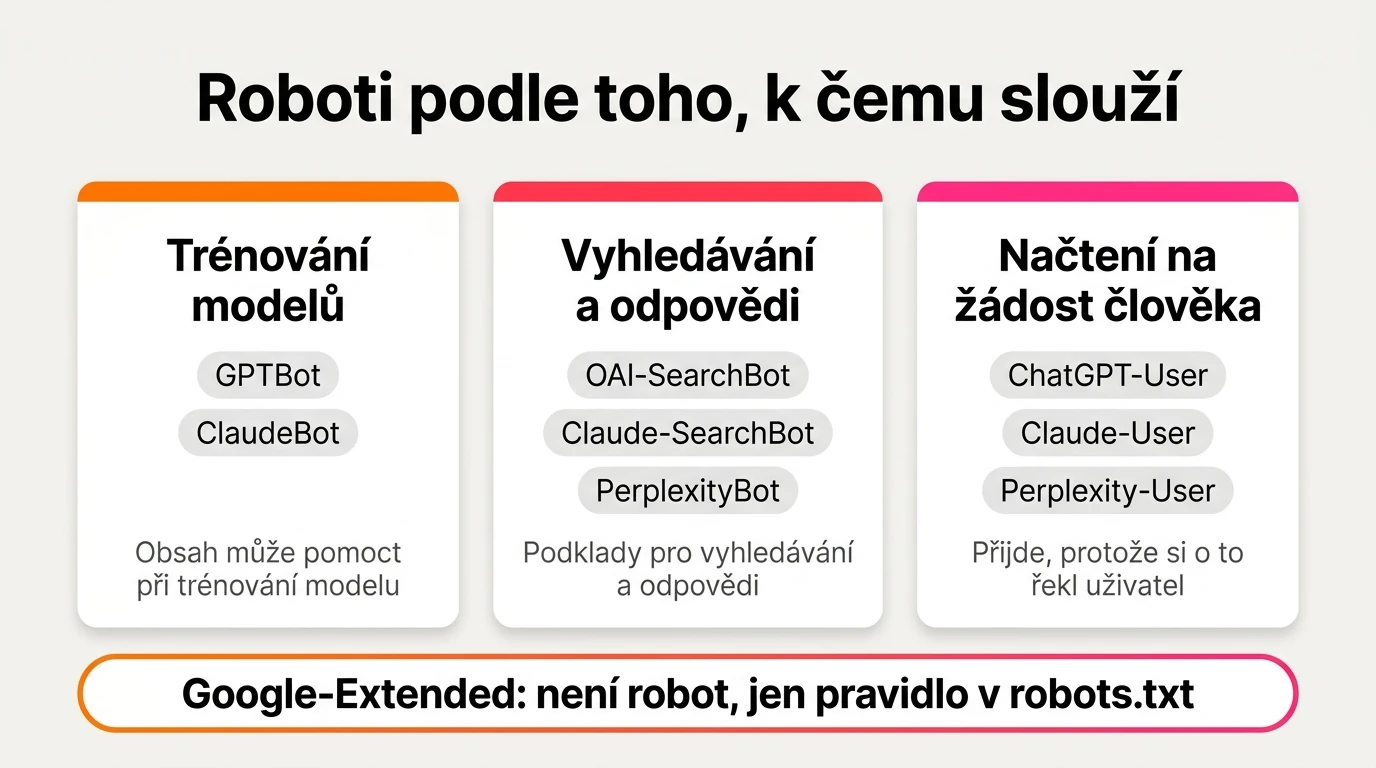
3 účely, 3 skupiny robotů. Google-Extended stojí mimo, protože žádný vlastní robot není.
Co z vaší stránky robot uvidí
Tady se často rozhoduje o tom, jestli se AI k obsahu webu vůbec dostane. Stránka může vypadat pro běžného návštěvníka naprosto v pořádku, ale robot z ní přesto uvidí jen část.
Většina AI robotů nespouští JavaScript stejně jako běžný prohlížeč. Pokud se tedy část obsahu doplní až po načtení stránky pomocí skriptu, robot ji nemusí vůbec zaznamenat.
Vercel to společně s MERJ testoval na hlavních AI robotech včetně ChatGPT a Claude. Výsledek byl shodný: obsah, který se vykreslí až na straně uživatele pomocí JavaScriptu, tito roboti nezpracovali. Doporučení je proto poměrně přímočaré: důležitý obsah by měl být součástí stránky už ve chvíli, kdy ji odešle server (Vercel, prosinec 2024).
Představte si to jako výlohu obchodu. Pokud do ní zboží vystavíte až ve chvíli, kdy zákazník vstoupí dovnitř, člověk ho uvidí. Robot, který jen projde kolem a podívá se dovnitř, ale uvidí prázdnou výlohu.
Ve stejném měření se ukázalo, že roboti si soubory s JavaScriptem sice stahují, ale nespouštějí je. U ChatGPT tvořily tyto soubory 11,50 % požadavků, u Claude 23,84 %. To samo o sobě tedy neznamená, že robot obsah vytvořený těmito skripty skutečně uvidí.
Existují ale výjimky. Google stránku dokreslit pomocí JavaScriptu umí. Ve své dokumentaci uvádí, že dokáže zpracovat i obsah vytvořený pomocí skriptů, pokud mu v tom technicky nebráníte (Google Search Central, 2026). Podobně může stránku plně načíst i AppleBot.
To vede k důležitému rozdílu. Stránka může být pro Google naprosto čitelná, ale pro ChatGPT nebo Claude může část jejího obsahu chybět.
U Webflow, na kterém stavíme weby, je základní obsah dostupný rovnou ve zdrojovém kódu stránky. Totéž platí pro naši platformu SA5. Ověřili jsme to například na e-shopu Valenta ZT (valentazt.cz): hlavní text stránky je přímo v kódu a OAI-SearchBot, GPTBot, PerplexityBot i ClaudeBot se na web dostanou bez blokace. Při našem měření v září 2026 všechny tyto požadavky skončily stavem 200.
Ani dobrá platforma ale není záruka, že robot uvidí všechno. Problém může nastat například u:
- obsahu, který se na stránku vloží až po načtení pomocí vlastního skriptu,
- recenzí, rezervačních systémů nebo chatů vložených z jiné služby,
- výpisů produktů nebo článků, které se zobrazí až po použití filtru nebo tlačítka načíst další,
- dat, která si stránka stáhne z jiného systému až po svém načtení.
Naopak záložky, slidery nebo rozbalovací sekce samy o sobě většinou problém nejsou, pokud je jejich obsah už součástí kódu stránky a skript ho pouze skrývá nebo zobrazuje.
Rozhodující tedy není to, jestli je obsah na první pohled vidět, ale jestli je v kódu stránky už od začátku. Pokud ano, robot se k němu zpravidla dostane. Pokud vznikne až po spuštění skriptu, část AI robotů ho vůbec neuvidí.
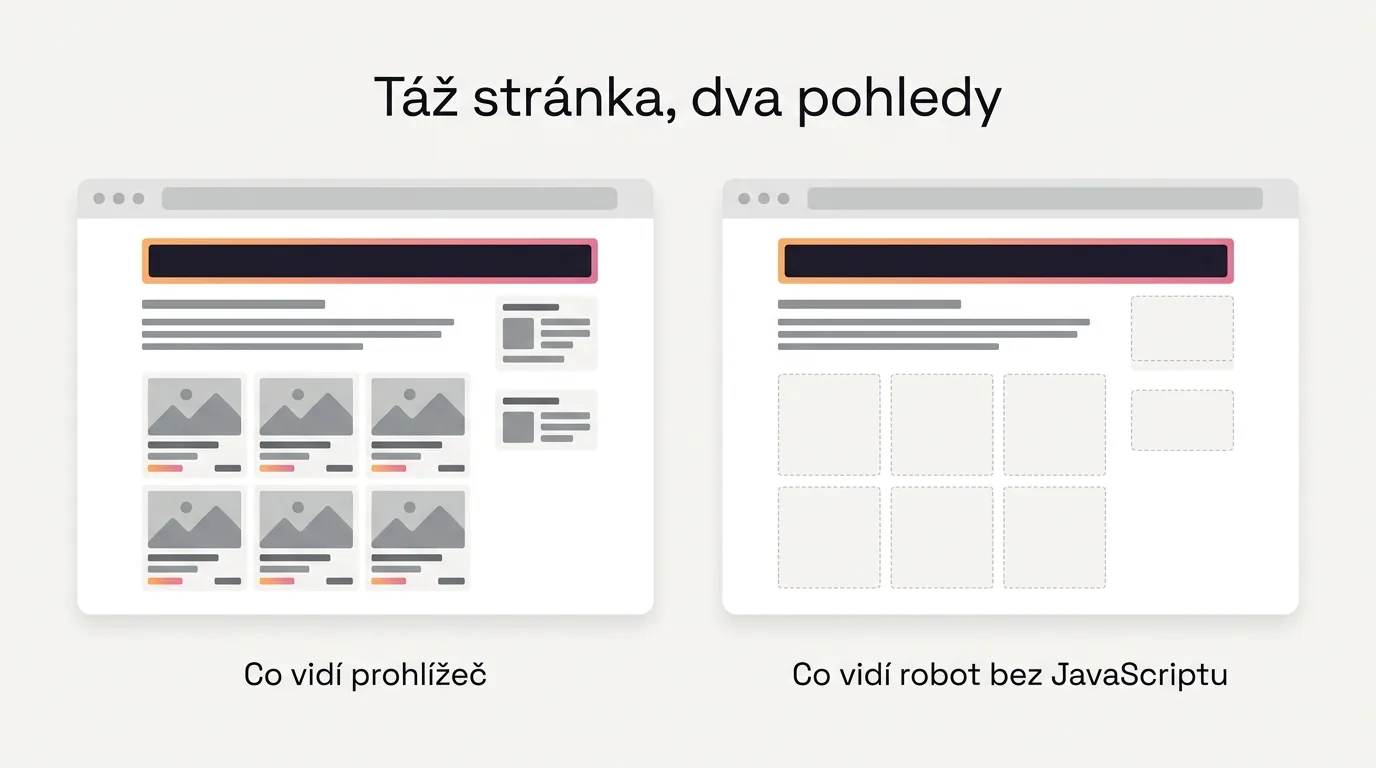
Táž stránka, 2 pohledy. Rozhoduje, co je v prvotním kódu.
Kde se to rozbije často, a robots.txt za to nemůže
Můžete mít správně nastavený robots.txt, obsah posílat rovnou ze serveru a přesto se k němu AI robot nedostane. Problém totiž často vzniká ještě dřív, než se robot vůbec dostane k samotné stránce.
Mezi internetem a vaším webem bývá další vrstva ochrany: firewall, ochrana proti útokům a robotům nebo CDN, tedy síť serverů, přes kterou se web doručuje uživatelům. Této vrstvě se často říká edge.
Je to virtuální vrátný. Každého příchozího nejdřív zkontroluje a teprve potom ho pustí dál. Pokud AI robota odmítne už tady, na obsahu stránky ani nastavení robots.txt už nezáleží. Robot se k nim vůbec nedostane.
Dobře je to vidět na Cloudflare. Ten od 1. července 2025 změnil výchozí nastavení a začal AI roboty blokovat, dokud za obsah tvůrcům nezaplatí. Nově registrované domény se rovnou ptají, jestli AI roboty pustit (Cloudflare, 2025).
Podobně OpenAI u svého vyhledávacího robota doporučuje povolit požadavky z jeho zveřejněných IP rozsahů. Pokud je firewall nebo CDN zablokuje, robots.txt situaci nezachrání.
Že nejde jen o teoretický problém, ukazují i česká data. Marek Frňka z Le Artist v srpnu 2026 otestoval 30 českých e-shopů a u 6 z nich dostal automatický požadavek odpověď 403, tedy přístup odmítnut. Pětina testovaných webů byla pro roboty nedostupná, aniž by to provozovatelé nutně zamýšleli (Le Artist, 2026).
Dobrá zpráva je, že se to dá snadno ověřit. Vývojář nebo agentura může web navštívit pod identitou konkrétního AI robota a podívat se, jaký stavový kód server vrátí.
200 znamená, že robot prošel. 403 znamená, že ho server odmítl.
Na Animato.cz jsme stejným způsobem v září 2026 ověřili OAI-SearchBot, GPTBot, PerplexityBot i ClaudeBot a ve všech případech jsme dostali odpověď 200. Ochranná vrstva tedy tyto roboty propouští.
To samozřejmě neznamená, že máte pustit všechno všude. Naopak dává smysl chránit citlivé části webu, například přihlášení, košík nebo administraci. U veřejných obsahových stránek je ale zbytečné AI roboty blokovat, byť i omylem.
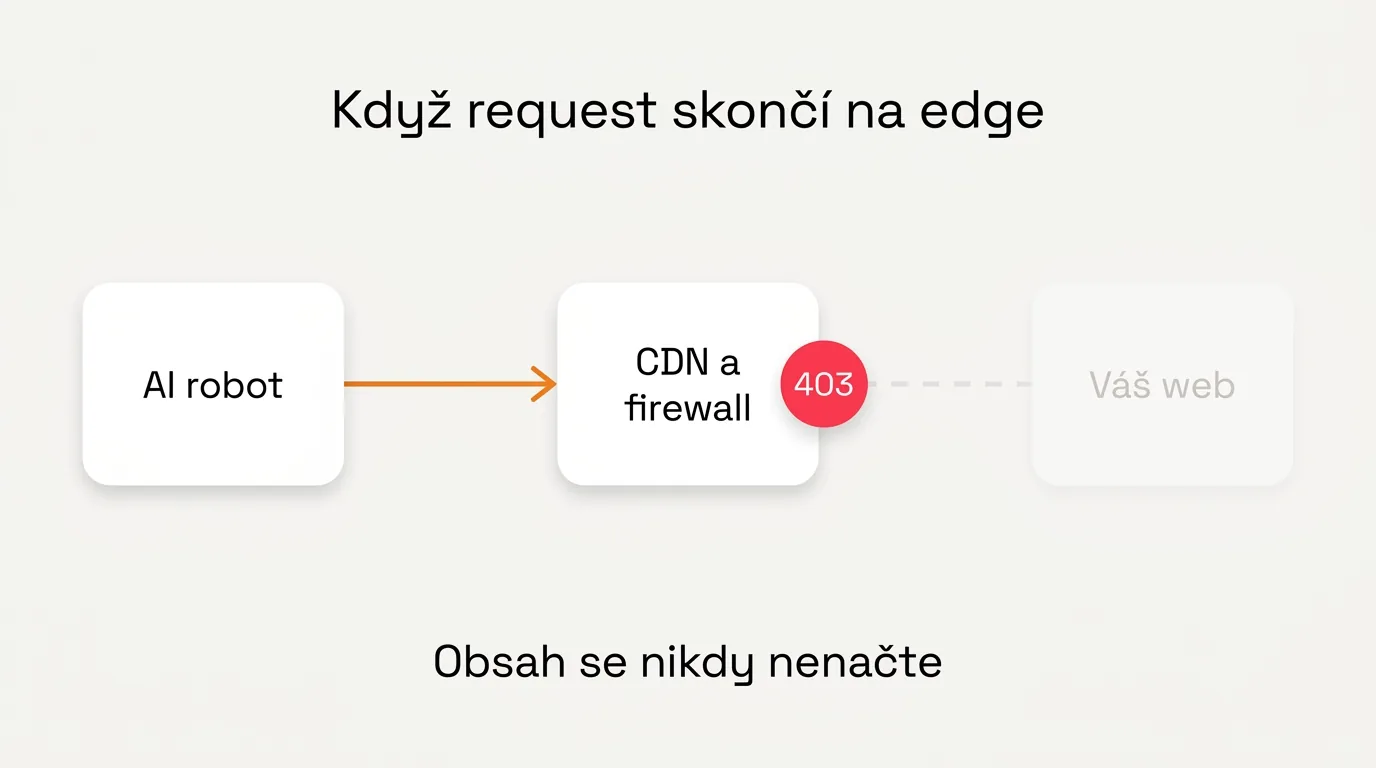
Když požadavek skončí u vrátného, na obsahu už nezáleží.
Než začnete ladit obsah, ověřte, že váš web robota vůbec pustí dovnitř.

Jak se vybere právě ta jedna pasáž
Kolem optimalizace pro AI vzniká nejvíc zmatku. Často se totiž směšují dva odlišné způsoby práce s obsahem: to, jak funguje Google, a to, jak fungují vlastní systémy postavené nad dokumenty a databázemi.
Začněme u Googlu. Když skládá odpověď pomocí AI, neopírá se jen o to, co má model v paměti. Vyhledá si aktuální stránky a použije je jako podklad pro odpověď. Google tomuto postupu říká grounding, tedy ukotvení odpovědi ve vyhledaných zdrojích. Podle jeho dokumentace k tomu používá stejné hlavní systémy vyhledávání, které rozhodují i o běžných výsledcích (Google Search Central, 2026).
To je důležitá informace: Google nepopisuje žádný zvláštní index jen pro AI, do kterého byste se museli dostat jinak než do běžného vyhledávání. Google navíc neumí posoudit jen stránku jako celek. Dokáže si všimnout i toho, že relevantní odpověď se nachází třeba jen v jednom konkrétním odstavci. K tomu používá systém označovaný jako passage ranking, který pomáhá vyhodnotit jednotlivé části stránky a podle nich určit její relevanci pro hledaný dotaz (Google Search Central, 2025). To ale ještě neznamená, že přesně víme, jak Google vybírá konkrétní větu nebo odstavec, který nakonec použije v AI odpovědi. Tento krok Google veřejně nepopisuje. Škoda.
A tady se dostáváme k časté radě: rozdělte obsah na co nejmenší kousky, aby mu AI lépe rozuměla. Google to jako požadavek výslovně odmítá. Podle jeho dokumentace není potřeba text uměle rozdělovat na malé části, jeho systémy dokážou pracovat i se stránkou, která obsahuje více témat (Google Search Central, 2026).
Odkud se tedy tahle rada vzala? Z jiného typu systémů. Firmy si často stavějí vlastní AI vyhledávání nad interními dokumenty, návody nebo databázemi. Tam se text skutečně rozděluje na menší části a každá z nich se převede do číselné podoby, která zachycuje její význam. Systém pak dokáže hledat části textu, které jsou si významově podobné, i když nepoužívají stejná slova (OpenAI, 2026).
Anthropic například testoval, co se stane, když se k takto rozděleným částem textu přidá ještě informace o jejich okolním kontextu. Chybovost při vyhledávání klesla z 5,7 % na 3,7 %. Po dalším přeřazení výsledků dokonce na 1,9 % (Anthropic, 2024).
Suma sumárum. Odstavec, který dává smysl i sám o sobě, se hledá a chápe snáz než odstavec, který bez předchozího textu nedává smysl.
Například věta „Proto je to nejlepší řešení" sama o sobě skoro nic neříká. Mnohem užitečnější je „Serverově vykreslený obsah je pro většinu AI robotů dostupnější, protože nevyžaduje spuštění JavaScriptu."
Tohle je dobrý princip pro psaní obsahu. A hned vysvětlíme proč.
U vlastních AI systémů je dělení textu na menší části běžnou technikou. Google ale nikde netvrdí, že stejným způsobem fungují Přehledy od AI. Rada psát jasné a samostatně srozumitelné odstavce tedy dává smysl. Jen není správné tvrdit, že je musíte sekat na kousky, aby je Google dokázal najít.
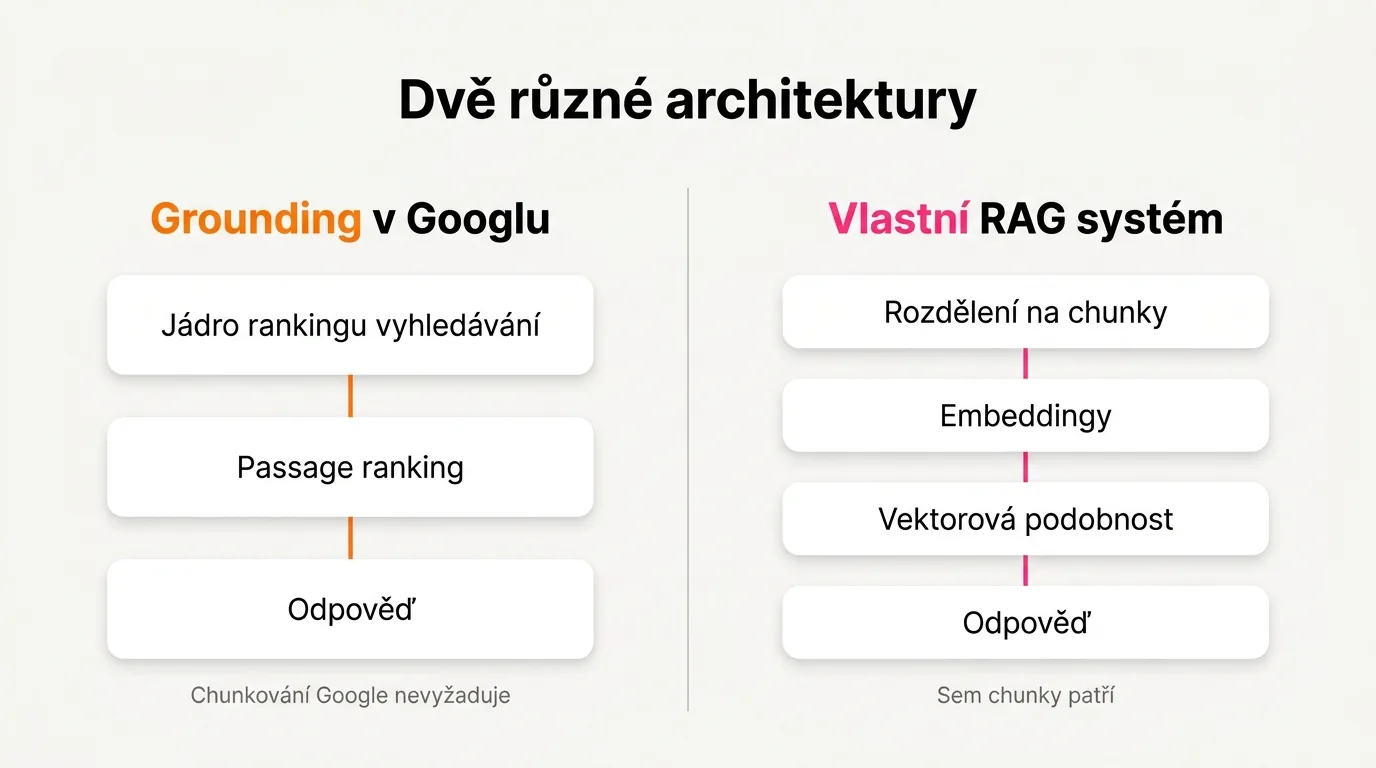
Kousky a čísla patří napravo. Doleva ne.
Jak se z pasáže stane citace
Anthropic ve své dokumentaci poměrně podrobně popisuje, co se děje ve chvíli, kdy Claude při odpovědi hledá na webu. Model se může rozhodnout vyhledávat, získat výsledky, použít je při tvorbě odpovědi a podle potřeby celý postup ještě několikrát zopakovat. Zajímavé jsou hlavně 3 detaily: citace jsou při webovém vyhledávání zapnuté vždy, samotný citovaný úryvek může mít maximálně 150 znaků a u každého výsledku se sleduje také informace o tom, kdy byla stránka naposledy aktualizovaná (Anthropic, stav k září 2026).
Těch 150 znaků je důležité chápat správně. Jde pouze o délku textu, který se nakonec zobrazí jako citace. Neznamená to, že model při hledání přečte jen 150 znaků, ani že kratší obsah dostává nějakou výhodu v pořadí výsledků. Z praktického pohledu ale dává smysl psát důležité informace tak, aby byly srozumitelné i samostatně. Krátká, konkrétní a dobře formulovaná věta má větší šanci, že i po vytržení z okolního textu bude pořád dávat smysl. Ne proto, že by AI automaticky zvýhodňovala krátké odstavce, ale jednoduše proto, že se podstatná myšlenka vejde do omezeného prostoru citace. I proto se vyplatí psát texty pořádně.
Samotná citace ale ještě není zárukou správnosti. Evropská vysílací unie spolu s BBC a 22 veřejnoprávními médii z 18 zemí, mezi nimi i Českým rozhlasem, prověřila více než 3 000 odpovědí ve 14 jazycích. Alespoň jeden závažný problém se objevil u 45 % odpovědí a vážný problém přímo se zdroji u 31 % (EBU a BBC, 2025). Rozdíly mezi jednotlivými nástroji byly výrazné. U Gemini mělo závažný problém se zdrojováním 72 % odpovědí, u ChatGPT 24 % a u Copilotu a Perplexity shodně 15 % (plná zpráva, s. 27).
To, že AI uvede zdroj, ještě neznamená, že zdroj skutečně potvrzuje to, co odpověď tvrdí. Citaci lze zkontrolovat a právě při kontrole se často ukáže, že odkaz vede na správnou stránku, ale vyvozený závěr už správný není.
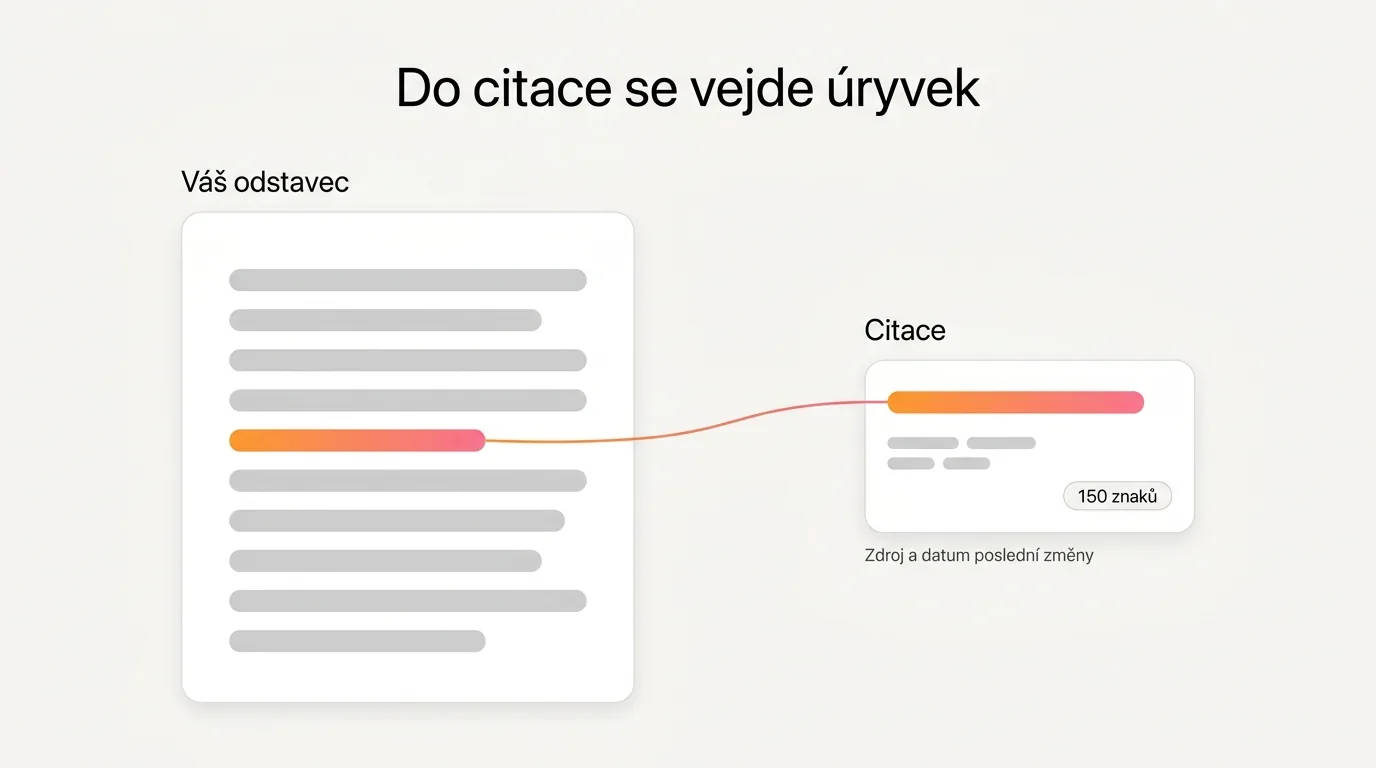
Do citace se dostane úryvek, ne celý odstavec.
Co je doložené a co si trh vymyslel
Kolem optimalizace pro AI se rychle nabalila spousta doporučení. Některá mají pevnou oporu v dokumentaci výrobců, jiná stojí na studiích, konferenčních výrocích nebo jen na opakovaném tvrzení bez jasného zdroje. Proto má smysl jednotlivé rady oddělit a podívat se, co o nich skutečně víme.
llms.txt
Soubor llms.txt je jednoduchý textový soubor umístěný v kořeni webu, ve kterém můžete stručně popsat jeho obsah pro jazykové modely. Návrh zveřejnil Jeremy Howard v září 2024 a druhá verze vyšla v srpnu 2026. Důležité ale je, že nejde o standard žádné standardizační organizace. Je to návrh, který se snaží zavést určitý zvyk, ne něco, co by výrobci AI museli podporovat.
Google říká poměrně jasně, že pro jeho vyhledávání takový soubor nepotřebujete. Není nutné vytvářet zvláštní textové soubory, speciální značky ani jiný formát určený jen pro AI a Google Search je pro účely vyhledávání ignoruje (Google Search Central, 2026). Z pohledu Googlu tedy llms.txt sám o sobě nepomůže ani neuškodí vaší viditelnosti.
Ještě důležitější je, že žádný z hlavních výrobců veřejně nedokumentuje, že by llms.txt používal při sestavování odpovědí. V září 2026 jsme prošli dokumentaci OpenAI, Anthropicu, Perplexity i Googlu a nikde není uvedeno, že by jejich systémy s tímto souborem pracovaly. To samozřejmě není důkaz, že ho nikdo nikdy nečte. Znamená to jen, že se k jeho podpoře žádný z těchto výrobců veřejně nezavázal.
Zároveň ale existují náznaky, že se kolem podobného formátu něco děje. Chrome přidal do vývojářského nástroje Lighthouse experimentální kategorii Agentic Browsing, která kontroluje, zda má web v kořeni strojově čitelné shrnutí (Chrome for Developers, 2026). Jde zatím o experiment bez výsledného skóre, takže z toho nejde vyvozovat, že se llms.txt stává standardem.
Asi nejpřesnější shrnutí nabízí samotný Webflow: llms.txt je signál, ne nástroj, kterým si něco vynutíte (Webflow University, 2026). V české praxi je jeho rozšíření zatím také malé. Z 30 e-shopů, které testoval Le Artist, jich 8 na adrese /llms.txt něco vracelo, ale jen 4 skutečný textový obsah (Le Artist, 2026).
Strukturovaná data
Strukturovaná data, často označovaná jako schéma, jsou informace zapsané přímo v kódu stránky tak, aby jim stroje dobře rozuměly. Mohou například jednoznačně určit, co je cena, jméno autora, datum vydání nebo hodnocení produktu.
Google u generativního vyhledávání říká, že strukturovaná data nejsou podmínkou a neexistuje žádné speciální schéma určené jen pro AI (Google Search Central, 2026). Microsoft je o něco vstřícnější. Fabrice Canel z Bingu na konferenci SMX v roce 2025 uvedl, že strukturovaná data mohou jejich modelům pomáhat lépe pochopit obsah stránky (Search Engine Land, 2025).
Tyto výroky si ale ve skutečnosti neodporují. Není to nutné a může to pomoct jsou dvě různé věci. Důležitý je spíš rozdíl v síle důkazu. Na straně Googlu máme oficiální dokumentaci, na straně Microsoftu veřejný výrok z konference přetlumočený médiem. Proto je rozumné strukturovaná data používat tam, kde dávají smysl i pro běžné vyhledávání a další systémy, ale nečekat od nich zvláštní zkratku k AI odpovědím.
Přepisování textů pro modely
Jedna z nejčastěji citovaných studií v této oblasti pochází z konference KDD 2024. Autoři v ní testovali 9 různých úprav textu a měřili, jak se projeví na viditelnosti v generovaných odpovědích. Přidání přímého citátu zvýšilo viditelnost o 41 %, statistiky o 33 % a uvedení zdrojů o 28 %. Naopak přehnané používání klíčových slov viditelnost snížilo o 9 % (arXiv, 2024).
Ta čísla vypadají lákavě, ale je potřeba k nim přistupovat opatrně. Studie byla podána už v roce 2023, pracovala s modelem GPT-3.5 a vůbec netestovala dnešní Přehledy od AI. Neříká, že přidáním statistiky dnes automaticky získáte o třetinu víc citací. Užitečnější je brát ji jako směr: text podložený konkrétními údaji, zdroji a citacemi může být pro generativní systémy užitečnější než text napěchovaný klíčovými slovy.
Zmínky a odkazy
Ahrefs v prosinci 2025 analyzoval 75 000 značek a hledal faktory, které souvisejí s tím, jak často je AI zmiňuje. Nejsilnější vztah našli u zmínek na YouTube, kde korelace dosáhla 0,737, následovaly zmínky značky na jiných webech s hodnotou 0,664. Naopak jejich vlastní metrika síly odkazového profilu, Domain Rating, skončila výrazně níž na 0,266 (Ahrefs, 2025).
Taková čísla ale neříkají, že stačí nakoupit zmínky na YouTube a AI vás začne doporučovat. Korelace ukazuje souvislost, ne příčinu. Silné a známé značky bývají zkrátka častěji zmiňované na více místech najednou. Sám Ahrefs na tuto výhradu upozorňuje a Google navíc výslovně varuje, že umělé shánění neautentických zmínek po webu nepomůže tolik, jak by se mohlo zdát (Google Search Central, 2026).
Praktický závěr proto není získat co nejvíc zmínek za každou cenu, ale spíš budovat skutečnou přítomnost značky tam, kde o ní lidé přirozeně mluví. To může znamenat média, odborné weby, videa, diskuse nebo jiné relevantní zdroje.
Vymyšlené mechaniky
Největší problém nastává ve chvíli, kdy se z rozumného principu začne dělat konkrétní mechanismus, který nikdo nikdy nedoložil. Na českých webech se například můžete dočíst o jakémsi Retrieval Modelu, který má údajně hodnotit autoritu zdrojů podle E-E-A-T. Žádná veřejná dokumentace Googlu takový modul nepopisuje. E-E-A-T, tedy zkušenost, odbornost, autorita a důvěryhodnost, je koncept z pokynů pro lidské hodnotitele kvality výsledků. Není to známý samostatný systém, který by stránkám přiděloval body.
Podobně je potřeba přistupovat k přesným číslům bez zveřejněné metodiky. Tvrzení, že správná hierarchie nadpisů přinese například 2,8krát více citací, zní velmi konkrétně, a právě proto působí důvěryhodně. Pokud ale pochází od firmy, která prodává nástroj pro optimalizaci do AI, a zároveň nezveřejnila způsob měření ani data, je takové číslo potřeba brát s velkou rezervou.
U optimalizace pro AI proto platí jednoduché pravidlo: čím přesnější a sebejistější tvrzení, tím důležitější je ptát se, odkud pochází a jak bylo ověřeno. Opakovaná rada ještě není důkaz.
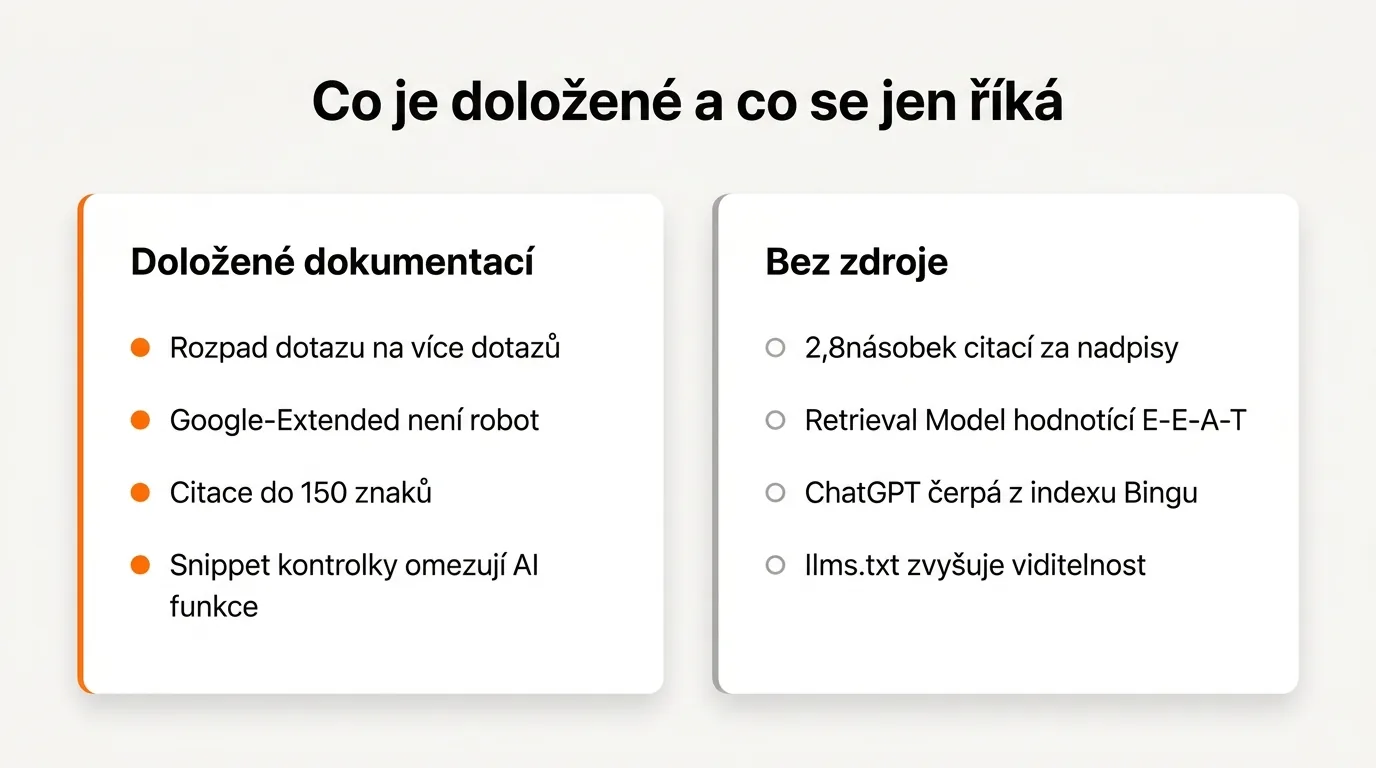
Vlevo dokumentace. Vpravo to, co se opakuje, dokud to nezní jako fakt.
Nakonec ještě jedna věc, která se týká i nás. Google dnes říká poměrně otevřeně, že optimalizace pro jeho generativní vyhledávání je pořád hlavně dobré SEO. Jinými slovy: pokud máte kvalitní, užitečný a dobře dostupný obsah, nedává smysl kvůli Přehledům od AI stavět úplně nový paralelní svět optimalizace (Google Search Central, 2026).
Tohle ale platí především pro Google. ChatGPT, Perplexity a další AI služby fungují jinak a řídí se vlastními pravidly. Google proto nemůže být univerzálním návodem pro celý trh. U těchto systémů je dobrý obsah pořád skvělý základ, ale sám o sobě nestačí. Záleží také na tom, jestli se k němu jejich roboti dostanou, jestli ho dokážou správně načíst a jestli se váš web vůbec objeví mezi zdroji, ze kterých si model odpověď skládá.
Čím to změříte
Od 31. srpna 2026 je v Search Console celosvětově dostupný samostatný report pro generativní AI. Je to zatím nejpřímější zdroj dat od Googlu, protože ukazuje, kolikrát se odkazy na váš web zobrazily uživatelům v generativních funkcích vyhledávání. Report zahrnuje jak Přehledy od AI, tak Režim AI (Google, 2026).
Má ale jedno důležité omezení: neukazuje prokliky, pouze zobrazení. Z reportu sice zjistíte, že se váš web v AI výsledcích objevil, ale ne kolik lidí z něj skutečně přišlo. A pokud web nemá dostatečný počet zobrazení, report se nemusí zobrazit vůbec. Kde ho v Search Console najdete a jak s ním pracovat, jsme popsali v návodu na Google Search Console.
Nástroje typu Marketing Miner AI Visibility měří něco trochu jiného. Nesledují přímo data z Googlu, ale testují předem připravenou sadu dotazů a zjišťují, jak často se vaše značka nebo web objeví v odpovědích různých AI nástrojů. Oba typy měření dávají smysl, jen odpovídají na jinou otázku. Search Console říká, jak jste vidět v generativních funkcích Googlu. Specializované nástroje zase ukazují, jak si vedete u konkrétních dotazů a napříč více AI službami.
Zajímavý obrázek přinesl v dubnu 2026 také výzkum Marketing Mineru, který vycházel ze 400 000 měření na 100 000 unikátních dotazech. Ukázal, že se typ citovaného zdroje výrazně liší podle oboru. V automotive tvořila 48 % citací média, v bankovnictví 44 % firemní weby, v energetice 49 % srovnávače a v lékárenství 79 % e-shopy.
Co to znamená v praktické rovině? Pokud například v energetice AI častěji cituje srovnávače než samotné dodavatele, nemusí být problém ve vašem webu. Může jít jednoduše o to, že se AI v daném oboru častěji opírá o jiný typ zdrojů. V takové chvíli nestačí upravit titulky, nadpisy nebo strukturu stránky. Je potřeba přemýšlet i nad tím, kde všude se vaše značka a informace o ní objevují a z jakých míst AI v daném oboru skutečně čerpá.
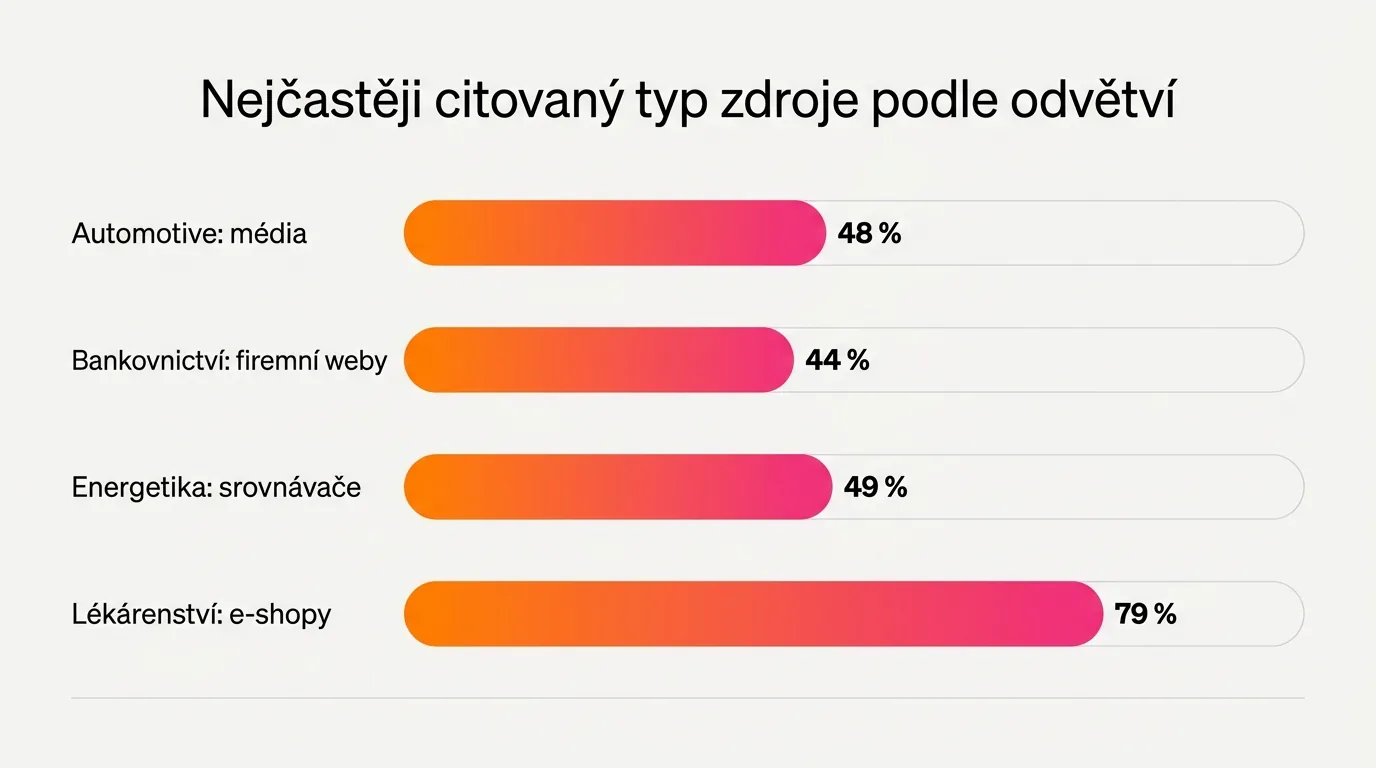
Zdroj: výzkum AI viditelnosti Marketing Mineru, 400 000 měření, duben 2026. Marketing Miner prodává nástroj na měření AI viditelnosti.
Chybí nám ale to podstatné. Systematická česká data, která by spojila návštěvy AI robotů na konkrétních stránkách se skutečnými prokliky lidí, zatím neexistují.
Co si z toho odnést
Mechanika není magie a většina jejích kroků je zdokumentovaná. Dá se podle ní postupovat. A zároveň je to nejlepší filtr na rady, které kolují: kdo tvrdí něco, co v žádné dokumentaci není, ten si to buď domýšlí, nebo prodává nástroj a argumenty mu slouží jako byznys plán.
Tři věci, které z toho plynou hned:
- Ověřte, co váš web vrací AI robotům. Ne robots.txt, ale skutečný návratový kód. Porucha bývá u vrátného a nikdo o ní neví.
- Nespoléhejte na to, co dokresluje skript. Co není rovnou v kódu stránky, pro většinu robotů neexistuje.
- Pište odpovědi tak, aby stály samostatně. Ne kvůli tomu, že to AI ocení, ale protože do citace se u Claude podle dokumentace Anthropicu vejde 150 znaků.
Praktické kroky, jak s tím pracovat dál, najdete v našem průvodci GEO. Tenhle článek popisoval mechaniku. Ten druhý ji převádí do práce na webu.